
A rede se mantém estável durante a operação normal, mas vários dispositivos não conseguem se reconectar após uma reinicialização geral do site. Uma possível causa é um limite de proteção configurado abaixo do pico de inicialização legítimo. Uma configuração de controle de tempestades que parece conservadora em uma rede ociosa pode se tornar prejudicial no momento em que a recuperação é mais importante.
O controle de tempestades limita o tráfego selecionado de acordo com as regras de classificação, medição e ação da plataforma. O mesmo número exibido pode significar taxas muito diferentes em interfaces ou dispositivos diferentes. Comece entendendo essas regras e, em seguida, use o tráfego de aplicativos observado para escolher e testar a política.
Identifique exatamente o que está sendo limitado.
Verifique se a configuração se aplica a broadcast, multicast, unicast desconhecido ou outra categoria documentada. Unicast conhecido e unicast desconhecido não são termos intercambiáveis, e multicast pode incluir tráfego essencial para o aplicativo.
Determine se as categorias são contabilizadas separadamente ou em conjunto e onde a medição ocorre. Leia a documentação exata do modelo em vez de presumir que o rótulo de menu de outro fornecedor, que você conhece, tenha o mesmo escopo.
Ciscoguia de configuração de controle de tempestadesIlustra o papel das classes de tráfego, limites e comportamento de supressão. Suas configurações e limitações de implementação são específicas da plataforma, portanto, use-o como uma referência conceitual e não como uma configuração pronta para outro switch.
Converta a unidade de limite antes de comparar as configurações.
Se um limite for expresso como uma porcentagem da largura de banda da interface, a velocidade da interface muda seu significado nominal. Um por cento de 1 Gb/s é 10 Mb/s, enquanto um por cento de 100 Mb/s é 1 Mb/s. Essas são ilustrações aritméticas; a granularidade real de contabilização e aplicação do hardware ainda precisa ser confirmada.
Um limite de pacotes por segundo mede uma quantidade diferente. Em um cenário ilustrativo de 1.000 pacotes por segundo, pacotes de 100 bytes representam 0,8 Mb/s dos bytes contabilizados, enquanto pacotes de 1.000 bytes representam 8 Mb/s. A sobrecarga na rede e a definição de comprimento contabilizado pelo switch podem alterar essa relação.
Essa diferença é importante quando uma carga de trabalho de controle de pacotes pequenos é comparada com pacotes de mídia maiores. Uma configuração copiada de outra porta pode impor um limite prático substancialmente diferente, mesmo quando ambas as portas mostram o mesmo número.
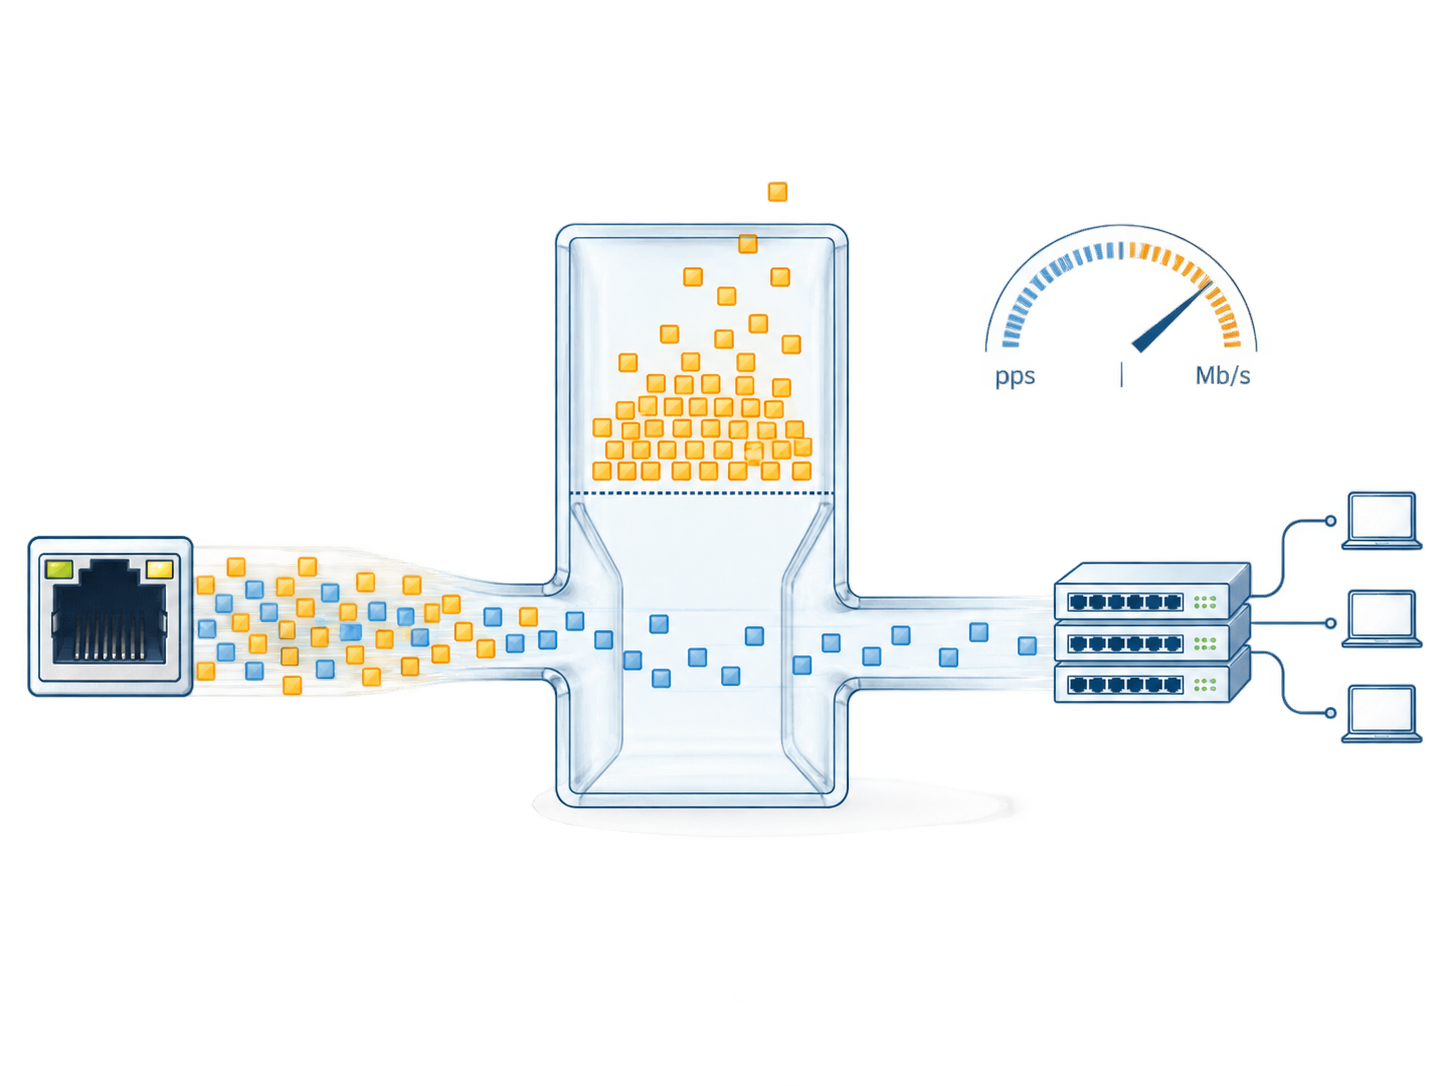
O tráfego médio não é suficiente para escolher o limite.
Observe a rede durante os estados que geram rajadas legítimas: inicialização, resolução de endereço, descoberta, ingresso em multicast, mudanças de topologia e reconexão de aplicativos. Identifique quais desses eventos se enquadram na classe de tráfego que está sendo controlada.
Utilize um intervalo de medição que revele o padrão relevante. Uma média longa pode suavizar um pico curto que o intervalo de aplicação do switch trata de forma diferente. Obtenha as especificações do dispositivo quanto ao comportamento do intervalo e do limite, quando documentadas, incluindo qualquer tolerância a picos ou arredondamento.
Mantenha as evidências de tráfego vinculadas à configuração e à carga de trabalho. Uma linha de base com cinco dispositivos conectados não é automaticamente adequada após a expansão para cinquenta. Uma nova versão de firmware ou modo de aplicativo também pode alterar o comportamento de descoberta e recuperação.
Escolha a ação com o mesmo cuidado que escolhe o limiar.
Dependendo da implementação, um evento pode suprimir tráfego selecionado, gerar um alarme, desativar uma porta ou combinar ações. Esses resultados têm consequências diferentes para o serviço. O fechamento de uma porta pode afetar todo o tráfego nessa porta, mesmo que o gatilho tenha se referido a uma única classe de tráfego.
Defina o que deve acontecer após o evento. O encaminhamento é recuperado quando a taxa cai abaixo de um nível documentado? Existe um limite de queda separado? Um operador precisa restaurar uma porta desativada? Se a recuperação automática estiver habilitada, o que impede que uma falha persistente reinicie a conexão repetidamente?
A política adotada deve responder a essas questões em termos operacionais. Um alarme que ninguém recebe não oferece a mesma proteção que um evento monitorado com um procedimento de resposta. Uma política de desligamento sem um método de recuperação acessível pode prolongar a interrupção que deveria conter.
Analise as portas de acordo com suas funções.
| Função do porto | Trânsito para entender | Preocupação com a revisão do limiar |
|---|---|---|
| Ponto final direto | Seu comportamento normal, de inicialização e de falha. | Uma linha de base estreita pode não detectar rajadas de recuperação válidas. |
| Comutador de acesso a jusante | Tráfego agregado de vários pontos de extremidade | Um limite de ponto final copiado pode ser muito restritivo. |
| caminho do receptor multicast | Grupos de mídia obrigatórios e sistemas de controle de acesso | O multicast essencial deve permanecer utilizável. |
| enlace ascendente redundante | Tráfego antes e depois de uma mudança de trajeto. | O caminho que sobreviveu pode suportar uma carga maior. |
| Ligação temporária para manutenção | Ferramentas esperadas e atividade de descoberta | O trabalho de curta duração deve seguir uma política portuária aprovada. |
Evite um valor universal para todas as interfaces, a menos que as evidências do projeto o justifiquem. A consistência na função da porta é mais útil do que a uniformidade numérica.
Validar tanto os casos saudáveis quanto os anormais.
Em um teste controlado, execute a carga de trabalho legítima durante a inicialização e a reconexão. Confirme se os serviços necessários são executados com sucesso, sem supressão ou desligamento inesperados. Observe os contadores e eventos relevantes, e não apenas se a conexão permanece ativa.
Em seguida, simule um caso de tráfego anormal aprovado em um ambiente isolado ou devidamente controlado. Verifique a ação pretendida e o efeito sobre os serviços não afetados. Registre a classe de tráfego, o padrão de tarifa, o tempo e o resultado da recuperação.
Não gere uma tempestade em uma rede de produção apenas para verificar se uma opção funciona. O ambiente de teste e o método de injeção devem corresponder ao processo aprovado do site. Um projeto piloto representativo pode estabelecer o comportamento antes que uma política seja implementada em larga escala.
Se um evento de limite for atingido durante o serviço normal, investigue a origem e o padrão antes de aumentar o limite. A causa pode ser uma expansão legítima, um ponto de extremidade mal configurado ou um loop de Camada 2 não intencional. Esses casos exigem correções diferentes.
Mantenha a prevenção de loops e o gerenciamento de membros ativados.
O controle de tempestades é uma proteção complementar, não um substituto para uma topologia livre de loops. Um loop pode continuar causando interrupções mesmo quando o tráfego selecionado é suprimido. Revise o cabeamento subjacente e o projeto de spanning tree ou anel quando as evidências apontarem para isso.
Da mesma forma, a distribuição indesejada de multicast pode exigir uma investigação de associação e de quem solicita o pacote. Reduzir drasticamente o limite de multicast pode mascarar o flooding, mas também prejudicar os receptores que precisam do fluxo de dados. Corrija o projeto de encaminhamento e, em seguida, valide a política de taxa com base no tráfego resultante.
O objetivo é conter comportamentos anormais, preservando a aplicação aceita. Isso requer tanto um projeto de rede sólido quanto uma resposta de proteção devidamente testada.
Documente o motivo de cada valor implementado.
Para umSeleção de switches gerenciáveis TODAHIKASolicite as classes de tráfego suportadas, unidades de limite, comportamento de medição, visibilidade de eventos e controles de recuperação para o modelo exato. Inclua as funções da porta e os requisitos críticos de inicialização na consulta.
Mantenha as configurações escolhidas juntamente com as observações de referência e os resultados dos testes. Indique qual alteração desencadeia a revisão: mais endpoints, um novo serviço multicast, uma alteração na velocidade de uplink ou uma sequência de recuperação revisada. Esse registro permite que o próximo engenheiro ajuste a política de forma deliberada, em vez de herdar um número inexplicável que pode não ser mais adequado à rede.
Data da publicação: 01/09/2026


